

บั๊กที่แก้ไม่จบในครั้งเดียวมักไม่ได้ซ่อนอยู่ในโค้ดบรรทัดเดียว มันอาจพาดผ่านหลายบริการ เกิดเฉพาะเมื่อมีการลองทำรายการซ้ำ หรือหายไปทันทีที่เปิดเครื่องมือดีบัก งานแบบนี้ต้องการทั้งคนที่ตั้งสมมติฐานได้ดีและความอดทนที่จะพิสูจน์ว่าต้นเหตุอยู่ตรงไหน ก่อนลงมือแก้ให้กระทบส่วนอื่นน้อยที่สุด
นี่เป็นภาพของงานที่ Google ใช้อธิบายตำแหน่งของ Gemini 4 Carbon ซึ่งประกาศเปิดให้เข้าถึงกว้างขึ้นเมื่อวันที่ 10 พฤศจิกายน 2026 หลังเปิดให้ผู้ป้องกันภัยไซเบอร์บางกลุ่มทดลองผ่าน Fairwind Program มาก่อนหน้า บริษัทระบุว่า Carbon เหมาะกับงานเขียนและแก้โค้ดหลายขั้น การวิเคราะห์เอกสารซับซ้อน และการค้นคว้าวิทยาศาสตร์ที่ยังไม่มีคำตอบตายตัว โดยยอมใช้โทเคนมากกว่า Gemini 4 Argon เพื่อสำรวจเหตุผลและวนตรวจงานนานขึ้น ประกาศของ Google
การเปิดตัวครั้งนี้จึงน่าสนใจตรงวิธีแบ่งงานให้โมเดลพอ ๆ กับความสามารถของตัวมันเอง หากงานส่วนใหญ่เป็นการแก้ฟีเจอร์ประจำวันหรือถามตอบที่ต้องการความเร็ว Google ยังแนะนำ Argon ส่วน Carbon มีเหตุผลที่จะถูกเลือกเมื่อความยากของโจทย์คุ้มกับเวลาและโทเคนที่เพิ่มขึ้น บทความนี้อ่านจากประกาศ เอกสารนักพัฒนา และรายงานการประเมินที่เผยแพร่ ไม่ใช่ผลทดสอบใช้งาน Carbon ของ Sukson
คิดนานขึ้น มีประโยชน์เมื่อรู้ว่ากำลังพิสูจน์อะไร
เอกสารนักพัฒนาระบุว่า Carbon กับ Argon ใช้กรอบบริบทรวมขนาดเดียวกัน มีเครื่องมือในตัวและราคาต่อโทเคนเท่ากัน ความต่างสำคัญอยู่ที่ความพยายามในการคิดแต่ละรอบ Carbon ใช้ thinking tokens หรือโทเคนสำหรับการให้เหตุผลมากกว่า จึงอาจตอบช้าลงและมีค่าใช้จ่ายต่อรอบสูงขึ้น แม้ตัวเลขราคาต่อหนึ่งล้านโทเคนจะดูไม่ต่างกัน แนวทางเลือกโมเดล
ลองนึกถึงทีมที่กำลังย้ายระบบหลายแพ็กเกจพร้อมกัน นี่เป็นตัวอย่างสมมติเพื่ออธิบายวิธีใช้ ไม่ใช่งานที่เรานำ Carbon ไปทดลอง ทีมอาจให้โมเดลที่ตอบเร็วจัดการการแก้ไฟล์ตามแผน ขณะที่มอบให้ Carbon ตรวจว่าการเปลี่ยนสัญญาระหว่างบริการทำให้เงื่อนไขเดิมเสียไปหรือไม่ ประโยชน์ที่ควรติดตามจึงเป็นจำนวนบั๊กที่พบและการทดสอบที่ผ่านจริง มากกว่าความยาวของคำอธิบายที่ได้รับ
Carbon ปรับระดับการคิดได้เป็น low, medium และ high โดย medium เป็นค่าเริ่มต้น Google แนะนำให้ประเมินกับงานของตัวเองแล้วเลือกระดับต่ำที่สุดที่ยังผ่านเกณฑ์คุณภาพ การตั้ง high ไว้ทุกคำขออาจเพิ่มเวลารอโดยไม่จำเป็น และ model card ก็ยังเตือนถึงคำตอบหลอน ความช้า และปัญหาหมดเวลาที่อาจเกิดขึ้นได้ เอกสารระดับการคิด · Model card
/swarm ให้หลายเอเจนต์ทำงานร่วมกัน แต่โควตาก็เดินเร็วขึ้น
Google เปิดตัว /swarm ใน Antigravity แบบพรีวิวควบคู่กัน แนวคิดคือให้เอเจนต์ผู้ประสานงานแบ่งโจทย์แก่ผู้ทำงานหลายตัว แยกพื้นที่แก้โค้ดด้วย git worktrees และมีเอเจนต์อีกบทบาทคอยทดสอบและทักท้วงการเปลี่ยนแปลง ทุกฝ่ายสื่อสารผ่านกระดานข้อความร่วมกัน ผู้ใช้ติดตามการทำงานได้จากหน้าจอของระบบ แทนที่จะเห็นเพียงคำตอบสุดท้าย
เอเจนต์ในทีมสามารถใช้คนละโมเดลได้ Google จึงเสนอให้ Carbon รับบทที่ต้องใช้เหตุผลหนัก เช่น วางสถาปัตยกรรม ประสานงาน หรือตรวจสอบ ขณะที่โมเดลที่เบากว่ารับงานแก้ไขประจำ ส่วน /swarm เริ่มทยอยเปิดแบบพรีวิวใน Antigravity App และ CLI อย่าเพิ่งตีความว่าเปิดครบทุกพื้นผิวที่รองรับ Carbon แล้ว รายละเอียดจากทีม Antigravity
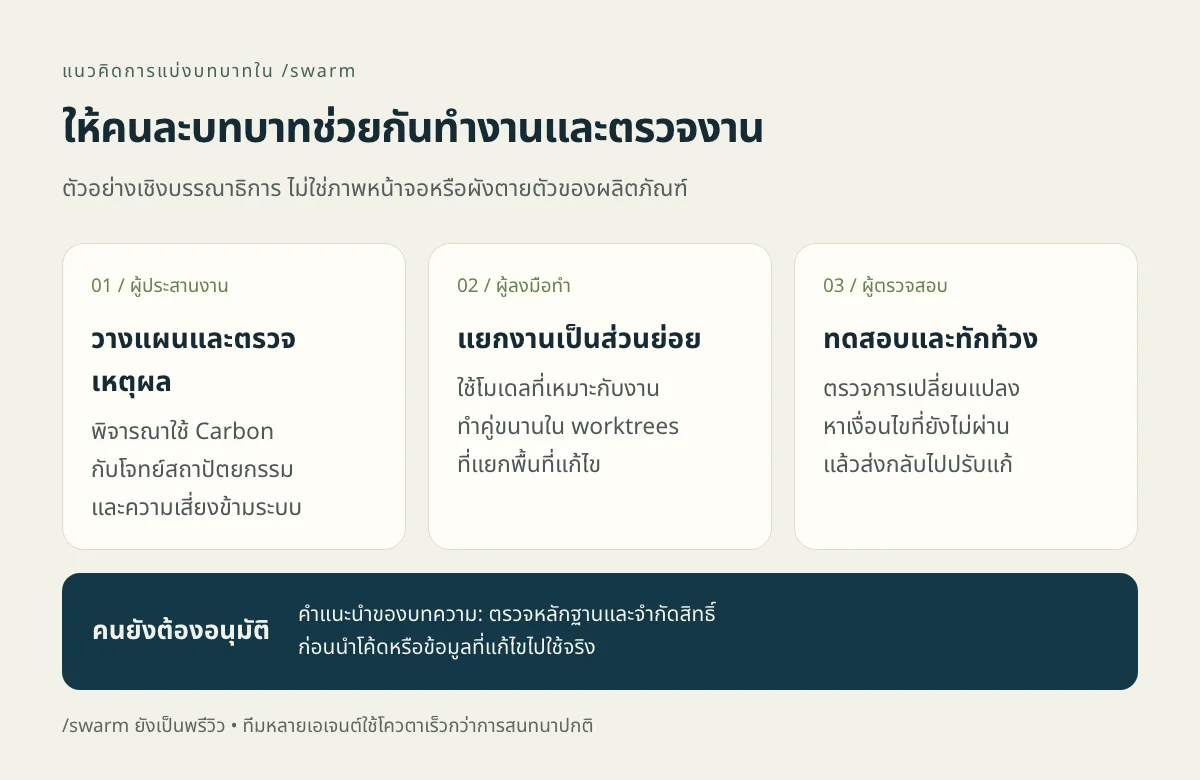
การมีผู้ตรวจสอบแยกจากผู้เขียนเป็นโครงสร้างที่มีประโยชน์ แต่ไม่ได้ทำให้การแก้โค้ดปลอดภัยโดยอัตโนมัติ ในการใช้งานจริง ทีมยังควรกำหนดสิทธิ์ของเครื่องมือ ขอบเขตข้อมูล และจุดที่ต้องขออนุมัติจากคน โดยเฉพาะก่อนนำโค้ดขึ้นระบบหรือแก้ข้อมูลสำคัญ ทีม Antigravity เตือนไว้เองว่าการทำงานหลายเอเจนต์พร้อมกันกินโควตาเร็วกว่าการสนทนาปกติมาก แม้การรอแบบว่างงานจะไม่ใช้โทเคนก็ตาม
อ่านคะแนนพร้อมอ่านเงื่อนไข
ประกาศของ Google ชูผลงานบน CursorBench 4.0, WANDR และ AutomationBench รวมถึงงานความรู้หลายรูปแบบ แต่คะแนนเหล่านี้ไม่ควรถูกรวมเป็นคำสัญญาว่า Carbon จะดีที่สุดสำหรับทุกทีม หน้าผลของ Cursor ที่ตรวจอ่านแสดง Carbon High ที่ 60.4% และ Medium ที่ 60.1% ขณะที่ Fable 5.2 Max อยู่ที่ 60.0% Cursor ระบุด้วยว่าผลอาจแปรผันและความต่างเล็กน้อยอาจไม่มีนัยสำคัญทางสถิติ CursorBench 4.0
AutomationBench ของ Zapier ให้ภาพอีกด้าน มันทดสอบว่าเอเจนต์ทำงานข้ามระบบจำลองธุรกิจได้สำเร็จจริงหรือไม่ โดยตรวจสถานะข้อมูลปลายทาง ไม่ใช่ตัดสินจากคำตอบที่ฟังดูมั่นใจ หน้าที่ตรวจอ่านแสดง Carbon High ได้ 53.88% และ Medium ได้ 52.97% ภายใต้เกณฑ์ที่ต้องผ่านเงื่อนไขครบจึงนับว่างานสำเร็จ แม้เป็นอันดับนำของตาราง คะแนนก็ยังห่างจากการทำงานถูกต้องทุกครั้ง AutomationBench
เอกสารวิธีประเมินของ Google ระบุว่าผลของ Gemini ใช้ระดับการคิดสูงสุดเป็นหลัก เว้นแต่จะบอกเป็นอย่างอื่น และหลายคะแนนของคู่แข่งนำมาจากตัวเลขที่ผู้ให้บริการนั้นรายงาน เงื่อนไขของแต่ละชุดทดสอบยังต่างกัน ทั้งเครื่องมือ เวลา และวิธีให้คะแนน จึงควรทดลองกับโจทย์จริงขององค์กรก่อนย้ายงานทั้งหมด ไม่ใช่อ่านเพียงอันดับหรือข้อความว่าใช้ต้นทุนต่ำกว่า วิธีประเมิน Gemini 4 Carbon
จากเอกสารหนา ๆ ไปถึงสมมติฐานในห้องแล็บ
งานความรู้ที่ Google ยกขึ้นมาเป็นจุดขายของ Carbon ไม่ได้หยุดอยู่ที่การย่อข้อความ บริษัทระบุว่าโมเดลอ่านข้อมูลจากเอกสารที่มีทั้งกราฟ ตาราง และภาพประกอบ แล้วสังเคราะห์เป็นรายงาน สเปรดชีต หรือสไลด์ตามรูปแบบที่กำหนดได้ดีขึ้น สำหรับคนทำงาน ความต่างที่ควรตรวจดูคือข้อสรุปยังผูกกับหลักฐานต้นทางหรือไม่ โดยเฉพาะเมื่อตารางกับเนื้อความอยู่คนละหน้า หรือเอกสารหลายฉบับให้ข้อมูลไม่ตรงกัน งานความรู้ในประกาศของ Google
ด้านวิทยาศาสตร์ Google เล่าว่านักวิจัยใช้ Carbon อ่านสมุดบันทึกแล็บและข้อมูลดิบเพื่อหาความผิดปกติของการทดลอง เช่น ปัญหาการผสมตัวอย่างไม่สมบูรณ์ รวมถึงใช้ร่วมกับโมเดลอื่นใน AlphaProof Code เพื่อช่วยสร้างบทพิสูจน์ทางคณิตศาสตร์เกี่ยวกับโค้ดของโปรโตคอล Signal ทั้งหมดเป็นกรณีที่บริษัทนำเสนอ ยังไม่ใช่หลักฐานว่าป้อนข้อมูลใดเข้าไปแล้วจะได้ข้อค้นพบที่ถูกต้องเสมอ ความหมายต่อผู้ใช้อยู่ที่การให้ AI ช่วยไล่สิ่งที่อาจตกหล่น โดยนักวิจัยยังต้องตรวจวิธีการและยืนยันผล
ความรู้ที่อยู่ในโมเดลเองก็มีขอบเขต Model card ระบุจุดตัดความรู้ไว้ที่เดือนมีนาคม 2026 และเตือนว่าบางสาขาอาจเก่ากว่านั้น งานที่ต้องใช้กฎหมาย งานวิจัย หรือข้อมูลล่าสุดจึงควรแนบแหล่งอ้างอิงปัจจุบันและตรวจกลับไปยังต้นฉบับ ไม่ถือว่าชื่อรุ่นใหม่เท่ากับรู้เรื่องใหม่ครบแล้ว ข้อจำกัดใน Model card
ราคาเปิดตัวมีวันสิ้นสุด และนับโทเคนที่ใช้คิดด้วย
สำหรับ Gemini API แบบ Standard ราคาเปิดตัวคืออินพุต 2 ดอลลาร์สหรัฐและเอาต์พุต 10 ดอลลาร์สหรัฐต่อหนึ่งล้านโทเคน ใช้ถึงวันที่ 30 พฤศจิกายน 2026 ตั้งแต่วันที่ 1 ธันวาคม 2026 จะเป็น 4 และ 20 ดอลลาร์ตามลำดับ เงื่อนไขนี้อยู่ในเชิงอรรถท้ายประกาศ และหน้าราคาก็แสดงวันที่ชัดเจน จึงไม่ควรนำราคาเปิดตัวไปตั้งงบระยะยาวโดยไม่มีเผื่อไว้ หน้าราคา API
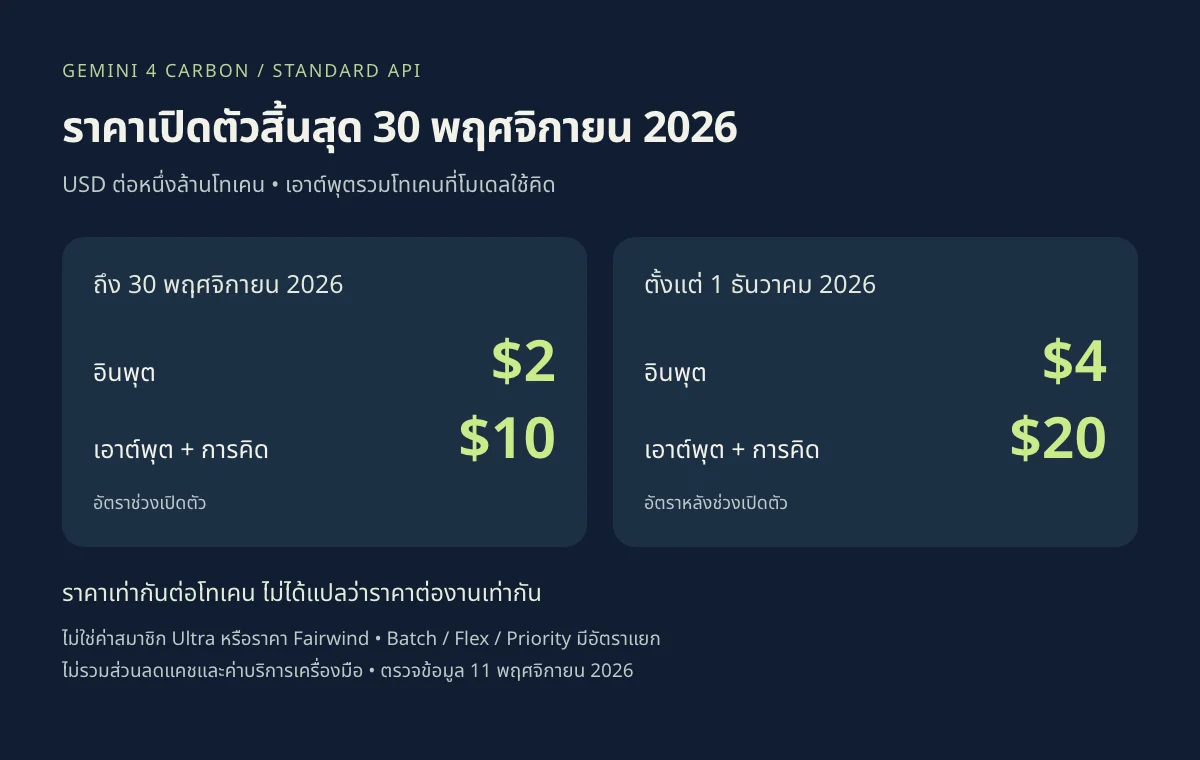
สมมติคำขอชุดหนึ่งใช้อินพุตที่ไม่ได้ส่วนลดแคชรวม 500,000 โทเคน และเอาต์พุตรวมการคิด 100,000 โทเคน ค่าโทเคนจะเป็น 2 ดอลลาร์ในช่วงเปิดตัว หรือ 4 ดอลลาร์ตามราคาตั้งแต่เดือนธันวาคม ตัวอย่างนี้เป็นการคำนวณจากอัตราที่ประกาศ ไม่ใช่ค่าใช้งานที่เราวัด และยังไม่รวมค่าการค้นหา เครื่องมือ หรือบริการอื่นที่อาจเกี่ยวข้อง
หน้าราคาระบุว่า Carbon ไม่มี Free tier สำหรับ API ส่วน Batch, Flex และ Priority มีอัตราแยกกัน การแคชของ Carbon รองรับแบบ implicit หรือระบบตรวจส่วนซ้ำให้เองเท่านั้น ไม่รองรับ explicit caching ที่ผู้พัฒนาสร้างรายการแคชเอง เอาต์พุตที่คิดเงินรวม thinking tokens ด้วย ดังนั้นการทำงานนานขึ้นเพื่อวนตรวจคำตอบจึงมีต้นทุนจริง แม้ข้อความที่ผู้ใช้เห็นจะสั้นก็ตาม
บริบทหนึ่งล้านโทเคน ไม่ใช่คำตอบยาวหนึ่งล้านโทเคนเสมอไป
Carbon รับข้อความ ภาพ วิดีโอ เสียง และ PDF เป็นข้อมูลเข้า แต่ผลลัพธ์ของโมเดลเป็นข้อความ การที่ตัวอย่างจาก Google สร้างแอปหรือฉากสามมิติได้จึงไม่เท่ากับว่า Carbon เป็นโมเดลสร้างภาพหรือเสียงในตัว เอกสารรุ่นระบุว่าไม่รองรับ image generation และ audio generation โดยตรง ข้อมูลรุ่น
กรอบบริบท 1,048,576 โทเคนเป็นพื้นที่ที่อินพุต การคิด และเอาต์พุตใช้ร่วมกัน คำตอบแบบ synchronous ปกติจำกัดที่ 65,536 โทเคน หากต้องการยาวกว่านั้น เอกสารแนะนำ background execution และต้องกำหนดเพดาน max_output_tokens ให้เกินค่านี้ โดยยังเหลือพื้นที่จากอินพุตภายในกรอบรวม การเปิด background อย่างเดียวโดยไม่เพิ่มเพดานไม่ได้ทำให้ได้คำตอบยาวขึ้นเอง ข้อกำหนด long decode
รายละเอียดเหล่านี้มีผลกับการย้ายระบบ หากใช้ Argon อยู่แล้ว Google ระบุว่าเปลี่ยน model ID ได้โดยไม่ต้องเปลี่ยนโครงสร้างคำขอ แต่ยังต้องทบทวนเวลารอและงบโทเคน ส่วนแอปที่ย้ายจาก Gemini รุ่นก่อนหน้าควรตรวจการแคชและพารามิเตอร์เดิมด้วย เอกสารระบุว่า temperature, top_p และ top_k ที่ส่งมาให้ Carbon จะถูกเพิกเฉย ไม่ควรสมมติว่าการตั้งค่าเก่ายังคุมผลได้เหมือนเดิม แนวทางย้ายระบบ
Carbon ทั่วไปกับ Carbon for cyber ต้องแยกให้ออก
ความสามารถไซเบอร์ที่ Google รายงานบน SEC-bench Pro, ExploitGym และ CWE-bench อ้างถึง Carbon เมื่อเข้าถึงผ่าน Fairwind Program สำหรับผู้ป้องกันที่ผ่านการตรวจสอบ ไม่ใช่คำรับรองว่าบัญชี API แบบชำระเงินทั่วไปจะได้สิทธิ์และความสามารถชุดเดียวกัน การสมัคร Fairwind ก็เป็นกระบวนการแยกต่างหากตามเกณฑ์ของโครงการ Model card และขอบเขตผลไซเบอร์
เรื่องความปลอดภัยก็ต้องอ่านให้ครบ Google รายงานอัตราโจมตีสำเร็จ 0% ในชุดทดสอบ Gray Swan IPI ซึ่งทดสอบการแทรกคำสั่งจากข้อมูลภายนอกเพื่อเบี่ยงให้เอเจนต์ทำตามผู้โจมตี แต่รายงานความปลอดภัยยังยอมรับว่าการโจมตีรูปแบบอื่นและการลองซ้ำอาจสำเร็จได้ ผลนี้จึงหมายถึงสิ่งที่เกิดขึ้นภายใต้ชุดทดสอบนั้น ไม่ได้แปลว่าปลอดจาก prompt injection ในทุกสภาพแวดล้อม รายงาน Safety & Security ส่วนที่ 6
สำหรับทีมที่นำเอเจนต์ไปอ่านเอกสาร เว็บไซต์ หรือโค้ดจากภายนอก ข้อควรทำในทางปฏิบัติจึงยังเหมือนเดิม: แยกข้อมูลออกจากคำสั่ง จำกัดสิทธิ์ที่ไม่จำเป็น และตรวจผลก่อนให้ระบบทำสิ่งที่ย้อนกลับยาก คำแนะนำนี้เป็นข้อเสนอในการใช้งานของบทความ ไม่ใช่ผลทดสอบเพิ่มเติมของโมเดล
ใครเริ่มใช้ได้ และควรเริ่มจากงานไหน
นักพัฒนาเข้าถึง Carbon ผ่าน Gemini API แบบจ่ายเงินใน AI Studio ส่วนองค์กรมีช่องทาง Gemini for business สำหรับผู้ใช้ทั่วไป Google ระบุว่ากำลังทยอยเปิดให้สมาชิก Google AI Ultra ใน Gemini app, AI Mode in Search และ Antigravity การประกาศว่าเริ่มเปิดใช้จึงไม่ใช่การยืนยันว่าทุกบัญชี ทุกประเทศ และทุกหน้าจอจะเห็นตัวเลือกพร้อมกัน ช่องทางเข้าถึงตามประกาศ
นักวิทยาศาสตร์และนักวิจัยยังสมัครโครงการเพื่อมีโอกาสใช้ Argon และ Carbon ผ่าน Antigravity ระดับโควตาสูงสุดโดยไม่เสียค่าใช้จ่ายหกเดือนได้ แต่มีเงื่อนไขด้านคุณสมบัติ ความจุ และการคัดเลือก พร้อมทยอยรับผู้ผ่านเกณฑ์ ไม่ใช่สิทธิ์ใช้ฟรีที่เปิดให้ทุกคนโดยอัตโนมัติ
ถ้าจะเริ่มประเมิน Carbon งานที่เหมาะน่าจะเป็นโจทย์ยากที่ทีมมีหลักฐานตรวจคำตอบได้อยู่แล้ว เช่น บั๊กที่มีกรณีทดสอบทำซ้ำได้ หรือรายงานจากเอกสารที่ระบุที่มาของทุกข้อสรุปได้ เก็บทั้งคุณภาพ เวลาที่ใช้ และค่าใช้จ่ายต่อชิ้นงาน แล้วเปรียบเทียบกับ Argon บนโจทย์เดียวกัน การตัดสินใจจะชัดขึ้นเมื่อรู้ว่าเวลาที่รอเพิ่มช่วยลดงานแก้หรือความผิดพลาดได้จริงแค่ไหน และงานส่วนใดควรปล่อยให้โมเดลที่เร็วกว่าเดินต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อแสดงความคิดเห็น
เข้าสู่ระบบกำลังโหลดความคิดเห็น…